
Tối ưu hóa hiệu suất data pipeline là gì?
Tối ưu hóa hiệu suất data pipeline là quá trình tinh chỉnh toàn diện các khâu thu thập, chuyển đổi, lưu trữ và điều phối dữ liệu nhằm giảm độ trễ, tiết kiệm tài nguyên tính toán và đảm bảo tính toàn vẹn thông tin cho doanh nghiệp. Tại ADC, chúng tôi định nghĩa đây là bài toán cốt lõi giúp các tập đoàn biến dữ liệu thô thành tài sản kinh doanh giá trị cao.
Định nghĩa kỹ thuật và ý nghĩa thương mại
Về mặt kỹ thuật, pipeline dữ liệu kết nối các nguồn phân tán lại với nhau thành một luồng tự động khép kín. Về mặt kinh tế, một hệ thống tối ưu sẽ giúp doanh nghiệp giảm đáng kể chi phí điện toán đám mây và hạn chế tối đa rủi ro mất mát dữ liệu chiến lược.
Phạm vi ứng dụng trong các tập đoàn lớn
Giải pháp này áp dụng trực tiếp cho các tổng công ty sở hữu lượng giao dịch lớn mỗi ngày như bán lẻ, tài chính ngân hàng hoặc sản xuất tích hợp IoT. Việc chuẩn hóa luồng dữ liệu giúp các cấp quản lý ra quyết định nhanh hơn dựa trên báo cáo thời gian thực.
Vì sao doanh nghiệp cần nâng cấp luồng dữ liệu định kỳ?
Ảnh: Campaign Creators / Unsplash
Nhiều tổ chức đối mặt với tình trạng hóa đơn hạ tầng tăng phi mã nhưng tốc độ truy xuất báo cáo lại chậm chạp do pipeline bị nghẽn cổ chai. Việc đánh giá và cải tiến định kỳ giúp doanh nghiệp duy trì lợi thế cạnh tranh trong kỷ nguyên số hóa mạnh mẽ.
Cắt giảm chi phí vận hành hạ tầng
Hệ thống cũ thường lãng phí tài nguyên do xử lý dư thừa và thiếu cơ chế phân loại dữ liệu thông minh. Tinh chỉnh giúp loại bỏ các tác vụ thừa, giảm dung lượng lưu trữ không cần thiết và tối ưu hóa chi phí thuê máy chủ.
Nâng cao độ chính xác cho mô hình AI và BI
Các thuật toán trí tuệ nhân tạo hoặc hệ thống báo cáo quản trị đòi hỏi dữ liệu sạch và cập nhật liên tục. Luồng dữ liệu mượt mà bảo đảm các mô hình dự báo không bị nhiễu thông tin đầu vào.
Quy trình từng bước triển khai tối ưu hóa dữ liệu
Việc cải tiến hệ thống đòi hỏi một lộ trình bài bản nhằm tránh làm gián đoạn các hoạt động kinh doanh cốt lõi hàng ngày của tổ chức. Dưới đây là checklist 4 bước thực chiến do đội ngũ kỹ sư ADC đúc kết từ các dự án thực tế.
Bước 1: Kiểm toán toàn diện luồng dữ liệu hiện tại
Doanh nghiệp cần rà soát lại toàn bộ các điểm nghẽn từ khâu hút dữ liệu nguồn đến kho lưu trữ đích. Xác định rõ các bảng dữ liệu bị trùng lặp hoặc các câu lệnh truy vấn tốn nhiều thời gian xử lý nhất.
Bước 2: Chuyển đổi từ xử lý hàng loạt sang phát trực tuyến
Tùy theo nhu cầu thực tế, chuyển dịch một phần các tác vụ từ mô hình chạy theo lô sang mô hình xử lý sự kiện thời gian thực. Điều này giúp giảm áp lực cho hệ thống vào các khung giờ cao điểm ban đêm.
Bước 3: Áp dụng cơ chế lưu trữ phân tầng thông minh
Phân loại dữ liệu theo tần suất sử dụng để đưa vào các tầng lưu trữ phù hợp với chi phí tối ưu. Dữ liệu ít truy cập sẽ được chuyển sang các ổ đĩa có chi phí thấp hơn nhưng vẫn bảo đảm khả năng phục hồi.
Bước 4: Thiết lập hệ thống giám sát và cảnh báo tự động
Cài đặt các công cụ theo dõi trạng thái pipeline để phát hiện sớm lỗi trước khi chúng ảnh hưởng đến bộ phận kinh doanh. Theo dõi tài liệu nhập môn data pipeline để nắm vững các nguyên lý nền tảng này.
Bảng so sánh các mô hình kiến trúc xử lý dữ liệu
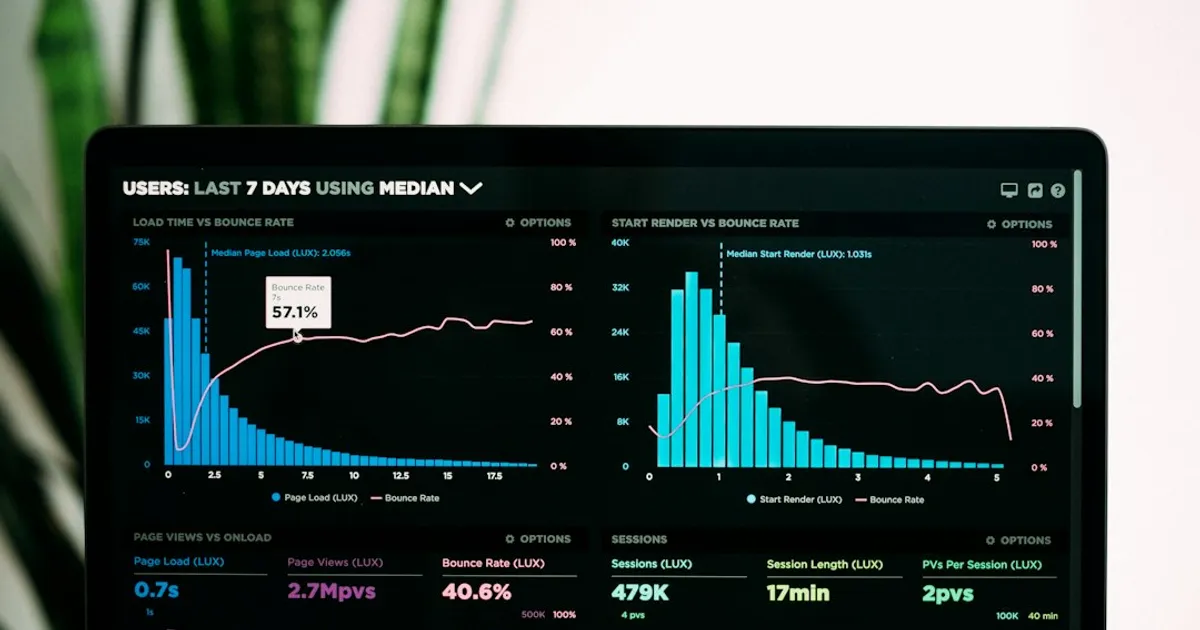
Việc lựa chọn đúng mô hình kiến trúc quyết định trực tiếp đến khả năng mở rộng quy mô và ngân sách đầu tư công nghệ dài hạn của doanh nghiệp. Dưới đây là tiêu chí so sánh chi tiết giữa ba mô hình phổ biến hiện nay.
| Tiêu chí đánh giá | Mô hình Batch Processing | Mô hình Streaming Processing | Mô hình Hybrid (Kết hợp) |
|---|---|---|---|
| Độ trễ dữ liệu | Tính bằng giờ hoặc ngày | Tính bằng giây hoặc mili-giây | Linh hoạt theo từng phân hệ |
| Chi phí vận hành | Thấp, dễ quản lý | Cao, đòi hỏi hạ tầng lớn | Tối ưu theo mức độ sử dụng |
| Độ phức tạp kỹ thuật | Thấp | Cao | Trung bình đến cao |
| Mức độ phù hợp | Báo cáo tài chính tháng | Cảnh báo gian lận, IoT | Doanh nghiệp quy mô lớn |
Những lỗi thường gặp và giải pháp khắc phục triệt để
Trong quá trình vận hành, nhiều doanh nghiệp thường vấp phải các sai lầm kinh điển làm suy giảm nghiêm trọng hiệu suất tổng thể. Nhận diện sớm giúp ban lãnh đạo chủ động phòng ngừa rủi ro tài chính.
Lỗi thiếu cơ chế kiểm soát trùng lặp bản ghi
Việc thiếu bước lọc dữ liệu trùng lặp dẫn đến phình to dung lượng lưu trữ và sai lệch chỉ số kinh doanh. Giải pháp là áp dụng các câu lệnh ghi idempotent để bảo đảm mỗi sự kiện chỉ được ghi nhận một lần duy nhất.
Lỗi bỏ qua việc phân quyền truy cập dữ liệu
Nhiều tổ chức gom toàn bộ dữ liệu vào một kho chung mà không phân chia cấp bậc bảo mật chặt chẽ. Doanh nghiệp cần thiết lập quy chế phân quyền rõ ràng theo vai trò nhân sự để bảo vệ thông tin nhạy cảm.
Kinh nghiệm thực tế từ góc nhìn đơn vị triển khai
Ảnh: Christina @ wocintechchat.com M / Unsplash
Trong một tình huống minh hoạ tại một tập đoàn bán lẻ quy mô lớn, hệ thống báo cáo doanh thu thường xuyên bị treo vào khung giờ cao điểm tối. Đội ngũ ADC đã tiến hành khảo sát, tái cấu trúc lại tầng chuyển đổi dữ liệu và áp dụng cơ chế nén thông minh.
Kết quả ghi nhận thời gian xử lý báo cáo hàng ngày giảm từ 4 giờ xuống chỉ còn chưa đầy 15 phút, giúp ban giám đốc nắm bắt kịp thời hành vi khách hàng. Đây là minh chứng rõ nét cho thấy giá trị thực tiễn của việc đầu tư đúng mức vào hạ tầng dữ liệu.
Các câu hỏi thường gặp về tối ưu hóa hiệu suất data pipeline
Tối ưu hóa hiệu suất data pipeline mất thời gian bao lâu?
Quá trình đánh giá hiện trạng và tối ưu hóa cơ bản thường kéo dài từ 4 đến 8 tuần tùy thuộc vào quy mô hệ thống. Tại ADC, chúng tôi luôn tiến hành khảo sát kỹ lưỡng trước khi đưa ra lộ trình chi tiết cho doanh nghiệp.
Doanh nghiệp vừa và nhỏ có cần đầu tư data pipeline phức tạp không?
Các doanh nghiệp vừa và nhỏ chỉ cần bắt đầu với các công cụ ETL dạng dịch vụ đám mây với chi phí tiết kiệm. Khi quy mô giao dịch mở rộng vượt ngưỡng hàng triệu bản ghi mỗi ngày, việc xây dựng một hệ thống chuyên nghiệp mới thực sự cần thiết.
Làm thế nào để đo lường ROI của dự án tối ưu hóa dữ liệu?
Hiệu quả đầu tư được đo lường cụ thể qua việc giảm chi phí thuê máy chủ đám mây, rút ngắn thời gian tạo báo cáo quản trị và gia tăng tốc độ phản ứng của các chiến dịch kinh doanh.
Có cần thay thế toàn bộ hệ thống cũ khi nâng cấp pipeline không?
Không nhất thiết phải thay thế toàn bộ hạ tầng sẵn có nếu các thành phần cũ vẫn đáp ứng tốt yêu cầu vận hành. Phương pháp tối ưu nhất là vá lỗi, nâng cấp từng phần và tích hợp thêm các công nghệ hiện đại thông qua API.
Vai trò của AI trong việc tự động hóa luồng dữ liệu là gì?
Trí tuệ nhân tạo hỗ trợ phát hiện sớm các điểm nghẽn, tự động điều chỉnh tài nguyên tính toán theo tải thực tế và dự báo trước các sự cố có thể xảy ra trong hệ thống.
Doanh nghiệp nên chuẩn bị gì trước khi làm việc với đơn vị tích hợp?
Ban lãnh đạo cần chuẩn bị sẵn danh sách các nguồn dữ liệu đang sử dụng, các báo cáo trọng yếu còn thiếu và các mục tiêu kinh doanh cụ thể cần giải quyết trong ngắn hạn.
Kết luận và định hướng hành động cho doanh nghiệp
- Xác định rõ các điểm nghẽn hiện tại trong hệ thống lưu trữ và xử lý dữ liệu của tổ chức.
- Ưu tiên chuẩn hóa luồng dữ liệu trước khi tích hợp các giải pháp AI hoặc Big Data phức tạp.
- Lựa chọn mô hình kiến trúc phù hợp với ngân sách và mục tiêu tăng trưởng dài hạn.
- {{INTERNAL_LINK}} để khám phá thêm các giải pháp công nghệ toàn diện cho doanh nghiệp.
Nếu doanh nghiệp của bạn đang gặp khó khăn với bài toán xử lý dữ liệu lớn, hãy liên hệ ngay với đội ngũ chuyên gia ADC Việt Nam để nhận lịch khảo sát và tư vấn giải pháp tối ưu hóa hiệu suất data pipeline phù hợp nhất.
