
Khi bạn mở điện thoại bằng khuôn mặt, hỏi trợ lý ảo một câu tiếng Việt hay nhận được gợi ý sản phẩm đúng thứ mình đang cần, phía sau những trải nghiệm quen thuộc đó rất có thể là Deep Learning. Công nghệ này đang thay đổi cách doanh nghiệp bán hàng, chăm sóc khách hàng, kiểm soát chất lượng và ra quyết định. Vậy Deep Learning là gì, khác Machine Learning ở điểm nào, và doanh nghiệp Việt Nam nên bắt đầu từ đâu? Bài viết này giải thích bằng ngôn ngữ dễ hiểu, để bất kỳ nhà quản lý nào — dù không có nền tảng kỹ thuật — cũng nắm được bản chất và nhìn ra cơ hội ứng dụng cho doanh nghiệp của mình.
1. Deep Learning là gì?
Deep Learning, hay học sâu, là một nhánh của Machine Learning — lĩnh vực mà máy tính học từ dữ liệu thay vì chỉ làm theo quy tắc do con người viết sẵn. Điểm đặc biệt của nó là sử dụng mạng nơ-ron nhân tạo có nhiều lớp, gọi là mạng nơ-ron sâu, để học trực tiếp từ dữ liệu thô. Chữ “sâu” ở đây chỉ số lượng lớp xử lý: mạng càng nhiều lớp thì càng học được những đặc điểm càng phức tạp, giống như con người học từ đơn giản đến phức tạp.
Hãy hình dung một đứa trẻ học nhận biết con mèo. Ban đầu, trẻ nhận ra những nét đơn giản như tai nhọn hay bộ ria. Sau nhiều lần nhìn thấy mèo ở nhiều tư thế và màu sắc khác nhau, trẻ dần nhận ra cả con vật dù nó đang cuộn tròn trong góc nhà. Deep Learning hoạt động tương tự: mô hình xem rất nhiều ví dụ, tự rút ra những đặc điểm quan trọng và dần giỏi hơn trong việc nhận diện, phân loại hay dự đoán.
Sức mạnh lớn nhất của Deep Learning là khả năng tự học đặc điểm từ dữ liệu lớn và dữ liệu phi cấu trúc như hình ảnh, âm thanh, video hay văn bản. Trước đây, muốn máy nhận ra khuôn mặt, con người phải chỉ cho máy biết khuôn mặt có mắt, mũi, miệng ra sao, bằng những quy tắc rất cụ thể và dễ sai khi điều kiện thay đổi. Với Deep Learning, mô hình tự tìm ra những đặc điểm có ích từ chính dữ liệu, nhờ đó phát hiện được những mẫu mà mắt thường hay các quy tắc viết tay khó nắm bắt — miễn là dữ liệu huấn luyện đủ nhiều, đủ đa dạng và đủ sạch. Với doanh nghiệp, đây là điểm mấu chốt: phần lớn dữ liệu tạo ra hằng ngày — ảnh sản phẩm, ghi âm cuộc gọi, tin nhắn khách hàng, hợp đồng — đều là dữ liệu phi cấu trúc, khó khai thác bằng phương pháp cũ nhưng lại rất giàu giá trị với mô hình học sâu khi được tổ chức đúng cách.
Trong đời sống, Deep Learning hiện diện nhiều hơn chúng ta tưởng: mở khoá bằng khuôn mặt, trợ lý ảo hiểu giọng nói, dịch máy, gợi ý nội dung trên các nền tảng video. Với doanh nghiệp, điều này mở ra cách làm việc mới: thay vì viết quy tắc cho từng tình huống, doanh nghiệp có thể để hệ thống học từ dữ liệu thực tế của chính mình. Tuy nhiên, cần hiểu đúng bản chất: mô hình không “hiểu” thế giới như con người, mà tìm ra các mối liên hệ thống kê trong dữ liệu để đưa ra dự đoán tốt nhất có thể. Nó rất giỏi với những việc lặp lại trên nhiều dữ liệu, nhưng vẫn cần con người đặt ra bài toán đúng, chuẩn bị dữ liệu tốt, kiểm tra kết quả và chịu trách nhiệm cho quyết định cuối cùng.
2. Mạng nơ-ron hoạt động ra sao?
Để hiểu Deep Learning, chỉ cần nắm ba ý tưởng: nơ-ron nhân tạo, các lớp xử lý và quá trình học từ sai lầm. Một nơ-ron nhân tạo là một đơn vị tính toán nhỏ: nó nhận vào một số tín hiệu, nhân mỗi tín hiệu với một “trọng số” thể hiện mức độ quan trọng của tín hiệu đó, cộng các kết quả lại rồi quyết định có “kích hoạt” hay không. Hàng nghìn, hàng triệu nơ-ron kết nối với nhau tạo thành mạng nơ-ron — mỗi nơ-ron giống như một người đưa ra một ý kiến nhỏ, và cả mạng cùng nhau đi đến một quyết định.
Một mạng nơ-ron sâu thường có ba loại lớp. Lớp đầu vào nhận dữ liệu thô, ví dụ từng điểm ảnh của một bức ảnh hay từng từ trong một câu. Các lớp ẩn ở giữa phân tích dần: lớp đầu nhận ra các đường nét đơn giản, lớp tiếp theo kết hợp chúng thành hình dạng, lớp sau nữa nhận ra bộ phận của đối tượng, cho đến khi mô hình nhận ra toàn bộ đối tượng. Cuối cùng, lớp đầu ra đưa ra kết quả, chẳng hạn “đây là sản phẩm đạt chuẩn” hay “khách hàng này có khả năng rời bỏ dịch vụ”. Mỗi lớp học một mức độ trừu tượng khác nhau, và chính sự xếp chồng nhiều lớp này tạo nên chữ “sâu” trong Deep Learning.
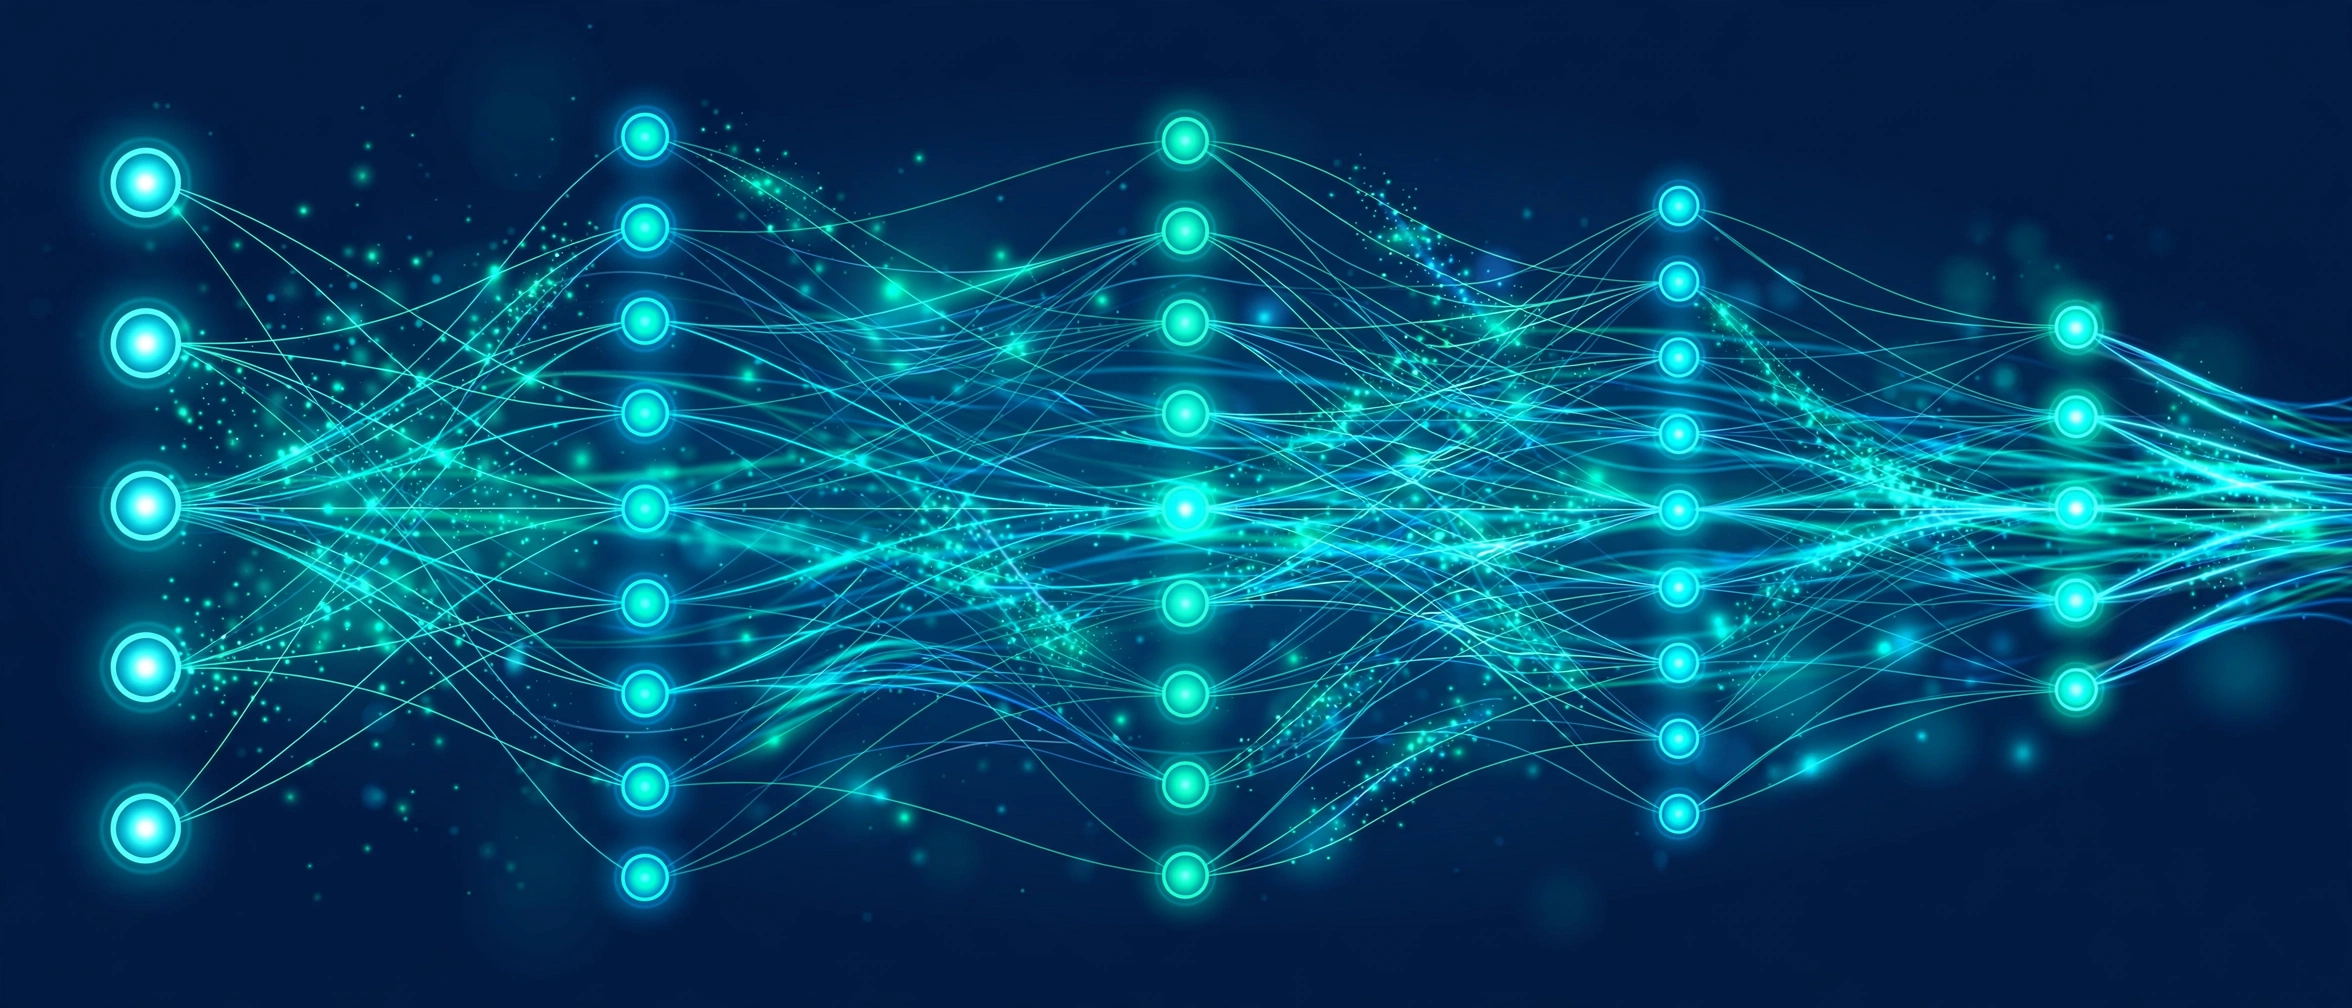
Vậy máy “học” bằng cách nào? Quá trình huấn luyện có thể tóm gọn trong một vòng lặp: dự đoán, so sánh, điều chỉnh, rồi lặp lại. Đầu tiên, mô hình nhìn vào một ví dụ có đáp án đã biết — chẳng hạn một bức ảnh được gắn nhãn “sản phẩm lỗi” — và đưa ra dự đoán của mình; lúc đầu, dự đoán gần như là đoán mò. Sau đó, hệ thống so sánh dự đoán với đáp án đúng để tính mức độ sai lệch, rồi điều chỉnh lại các trọng số: giảm ảnh hưởng của những tín hiệu đã dẫn đến dự đoán sai, tăng ảnh hưởng của những tín hiệu hữu ích. Quá trình này lặp lại qua hàng nghìn, hàng triệu ví dụ cho đến khi mô hình dự đoán ngày càng chính xác. Người làm kỹ thuật còn chia dữ liệu thành tập huấn luyện và tập kiểm tra: một phần dùng để dạy mô hình, phần còn lại — mà mô hình chưa từng thấy — dùng để kiểm tra xem nó có thực sự học được quy luật hay chỉ “học thuộc lòng” các ví dụ cũ. Hiện tượng học thuộc lòng nhưng không khái quát được sang dữ liệu mới gọi là quá khớp, và tránh nó là một phần quan trọng của việc xây dựng mô hình tốt.
Tuỳ bài toán, mô hình có thể học theo nhiều cách. Phổ biến nhất là học có giám sát, khi mỗi ví dụ huấn luyện đều kèm đáp án — như ảnh sản phẩm được gắn nhãn đạt hay lỗi, email được đánh dấu là spam hay không. Khi không có sẵn đáp án, mô hình học không giám sát bằng cách tự tìm nhóm và cấu trúc ẩn trong dữ liệu, ví dụ gom khách hàng thành các nhóm có hành vi giống nhau. Ngoài ra còn có học tăng cường, khi hệ thống học bằng cách thử và nhận phản hồi: hành động tốt được thưởng, hành động sai bị phạt, và dần dần hệ thống tìm ra chiến lược tốt nhất. Dù theo cách nào, nguyên tắc chung vẫn không đổi: mô hình cải thiện dần qua dữ liệu và phản hồi, và chất lượng dữ liệu cùng cách đánh giá quyết định phần lớn chất lượng cuối cùng. Deep Learning phát triển mạnh những năm gần đây cũng nhờ ba điều kiện cùng chín muồi: dữ liệu lớn từ các hệ thống số, phần cứng xử lý mạnh mẽ hơn và các phương pháp huấn luyện hiệu quả hơn. Vì vậy, doanh nghiệp muốn ứng dụng Deep Learning thường phải bắt đầu từ việc làm sạch và tổ chức dữ liệu, chứ không phải từ việc chọn mô hình phức tạp nhất.
3. Deep Learning khác Machine Learning và AI truyền thống thế nào?
Ba thuật ngữ AI, Machine Learning và Deep Learning thường bị dùng lẫn lộn, nhưng thực tế chúng lồng vào nhau như những vòng tròn đồng tâm. AI là khái niệm rộng nhất: bất kỳ hệ thống nào thể hiện hành vi thông minh — từ một chương trình chơi cờ theo quy tắc cho đến một trợ lý ảo — đều có thể gọi là AI. Machine Learning là một hướng đi bên trong AI: thay vì viết ra mọi quy tắc, người ta cho máy học từ dữ liệu. Deep Learning là một nhánh bên trong Machine Learning, dùng mạng nơ-ron nhiều lớp để học những đặc điểm phức tạp trực tiếp từ dữ liệu thô. Nói cách khác, mọi mô hình Deep Learning đều là Machine Learning, và mọi hệ thống Machine Learning đều là AI, nhưng điều ngược lại thì không đúng.
AI truyền thống, hay AI dựa trên quy tắc, hoạt động bằng cách con người viết ra các luật “nếu… thì…”. Ví dụ, một hệ thống chấm công có thể quy định: nếu nhân viên vào sau một giờ nhất định thì ghi nhận đi muộn. Cách này dễ hiểu, dễ kiểm soát và hiệu quả với những bài toán có quy tắc rõ ràng, ổn định. Nhược điểm là khi bài toán phức tạp và có quá nhiều ngoại lệ, con người không thể viết đủ quy tắc, và hệ thống trở nên cứng nhắc, khó mở rộng. Machine Learning truyền thống khắc phục một phần bằng cách học quy tắc từ dữ liệu, nhưng vẫn cần con người chuẩn bị và chọn ra những đặc điểm quan trọng trước khi đưa vào mô hình — chẳng hạn, để dự báo khách hàng rời bỏ dịch vụ, người phân tích phải tự tính trước các đặc điểm như tần suất mua hàng hay số lần liên hệ hỗ trợ. Deep Learning đi xa hơn: nó tự học đặc điểm từ dữ liệu thô, đặc biệt hiệu quả với hình ảnh, âm thanh và văn bản. Cái giá phải trả là nhu cầu dữ liệu lớn hơn, thời gian huấn luyện lâu hơn, chi phí tính toán cao hơn và kết quả khó giải thích hơn.
| Tiêu chí | AI truyền thống (dựa trên quy tắc) | Machine Learning | Deep Learning |
|---|---|---|---|
| Cách hoạt động | Con người viết quy tắc “nếu… thì…” | Máy học quy tắc từ dữ liệu | Mạng nơ-ron nhiều lớp tự học đặc điểm từ dữ liệu thô |
| Dữ liệu phù hợp | Bài toán có luật rõ ràng, ít thay đổi | Dữ liệu có cấu trúc, quy mô vừa phải | Dữ liệu lớn, phức tạp, phi cấu trúc như ảnh, âm thanh, văn bản |
| Chuẩn bị đặc điểm | Con người định nghĩa toàn bộ | Con người chọn và tính toán đặc điểm | Mô hình tự học đặc điểm |
| Chi phí và độ phức tạp | Thấp, dễ triển khai | Trung bình | Cao, cần nhiều dữ liệu và sức mạnh tính toán |
| Khả năng giải thích | Rất dễ hiểu và kiểm soát | Thường dễ giải thích | Khó giải thích vì sao mô hình đưa ra một quyết định cụ thể |
| Ví dụ | Hệ thống chấm công theo giờ, chatbot trả lời theo từ khóa cố định | Dự báo doanh số từ bảng số liệu, phân loại khách hàng | Nhận diện khuôn mặt, chatbot hiểu ngôn ngữ tự nhiên, kiểm tra lỗi bằng hình ảnh |
Nguyên tắc quan trọng khi lựa chọn công nghệ là: chọn công nghệ phù hợp với bài toán, không chọn công nghệ ấn tượng nhất. Một doanh nghiệp nhỏ muốn phân loại khách hàng theo lịch sử mua hàng có thể không cần mạng nơ-ron sâu; một bảng tính có cấu trúc tốt cùng một mô hình Machine Learning đơn giản có thể đã đủ. Ngược lại, một nhà máy muốn kiểm tra hàng nghìn sản phẩm bằng hình ảnh mỗi ngày, hay một công ty muốn chatbot hiểu được tiếng Việt tự nhiên với nhiều cách diễn đạt khác nhau, sẽ thấy Deep Learning phát huy giá trị rõ rệt. Người quyết định không cần biết chi tiết kỹ thuật, nhưng cần nắm được sự khác biệt này để đặt đúng kỳ vọng và tránh đầu tư vào công nghệ quá sức so với bài toán thực tế. Với dữ liệu bảng có cấu trúc rõ ràng và quy mô vừa phải, các phương pháp Machine Learning truyền thống thường đủ tốt, nhanh hơn và dễ hiểu hơn; Deep Learning thực sự tỏa sáng khi dữ liệu lớn, phức tạp và phi cấu trúc.
4. Ứng dụng đột phá của Deep Learning trong doanh nghiệp
Deep Learning không còn là câu chuyện của phòng thí nghiệm. Nhiều ứng dụng đã trở nên quen thuộc và đang mang lại giá trị rõ rệt cho doanh nghiệp ở nhiều ngành nghề. Dưới đây là những ứng dụng tiêu biểu mà doanh nghiệp Việt Nam có thể tham khảo, từ những bài toán đã phổ biến đến những hướng đi cần đầu tư dài hơi hơn.
4.1. Chatbot và chăm sóc khách hàng
Đây là một trong những ứng dụng dễ thấy nhất. Chatbot thế hệ mới, được xây dựng trên các mô hình ngôn ngữ học sâu, có thể hiểu câu hỏi của khách hàng dù họ diễn đạt theo nhiều cách khác nhau, kể cả khi câu chữ chưa chuẩn chỉnh hay tiếng Việt có nhiều từ đồng nghĩa. Thay vì chỉ trả lời theo từ khóa cố định, chatbot có thể tra cứu thông tin sản phẩm, hướng dẫn sử dụng, kiểm tra tình trạng đơn hàng và chuyển cho nhân viên khi gặp vấn đề vượt quá khả năng xử lý.
Giá trị lớn nhất nằm ở tính liên tục: chatbot hoạt động 24/7, trả lời ngay lập tức vào buổi tối, ngày lễ hay khi lượng truy vấn tăng đột biến. Nhân viên chăm sóc khách hàng nhờ đó được giải phóng khỏi những câu hỏi lặp lại để tập trung vào các trường hợp phức tạp, cần sự thấu hiểu và linh hoạt của con người. Tuy nhiên, chatbot chỉ thực sự tốt khi được huấn luyện trên dữ liệu thật của doanh nghiệp — các câu hỏi thường gặp, tình huống thực tế và giọng văn thương hiệu — và khi có cơ chế chuyển giao mượt mà cho con người. Một chatbot trả lời sai hoặc trả lời vòng vo có thể gây khó chịu hơn là không có chatbot. Vì vậy, doanh nghiệp nên bắt đầu với phạm vi hẹp, đo lường mức độ hài lòng của khách hàng và mở rộng dần.
4.2. Dự báo doanh số và nhu cầu
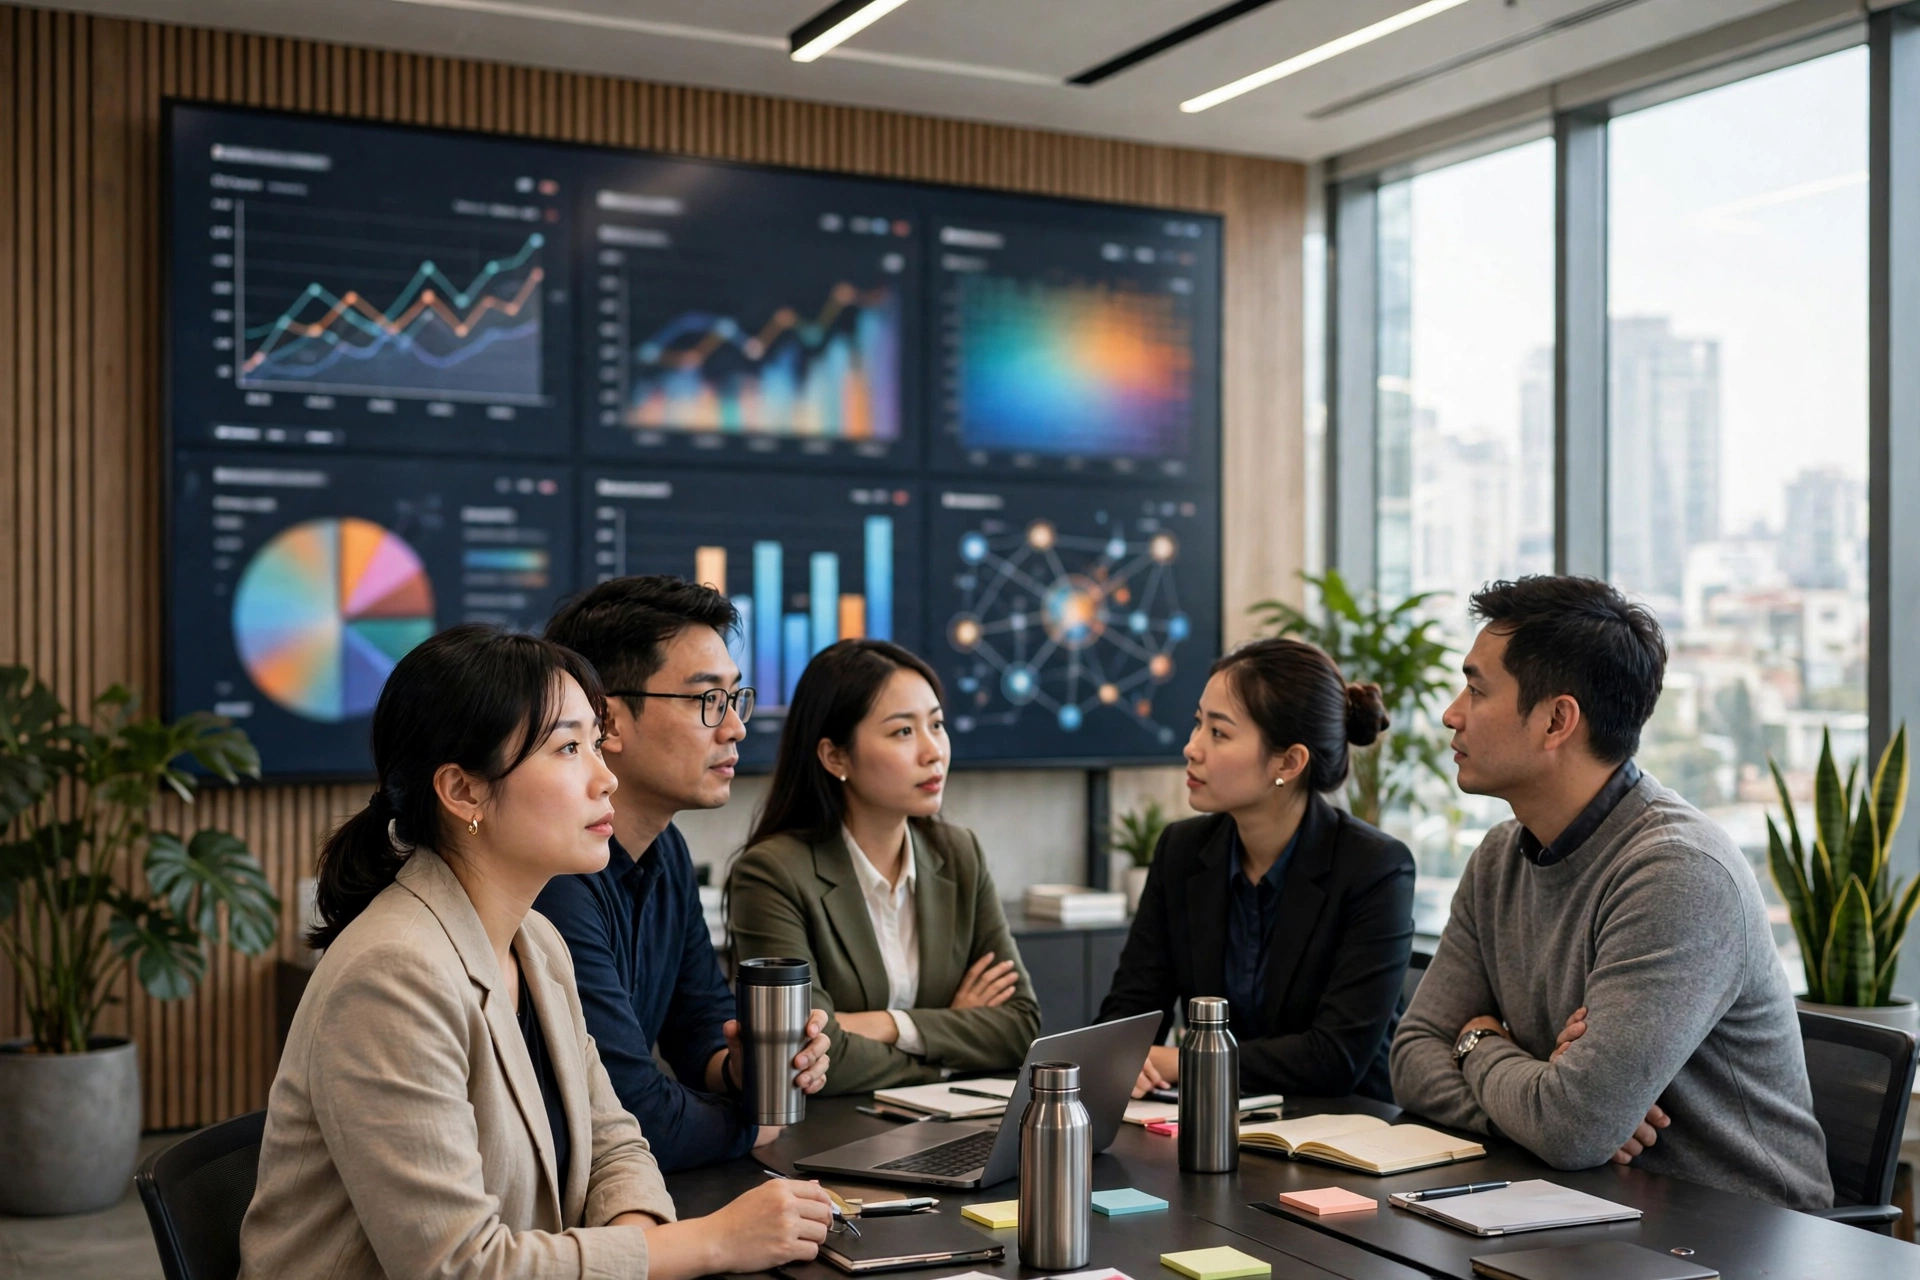
Dự báo là bài toán kinh điển mà Deep Learning thể hiện sức mạnh. Doanh số chịu tác động của nhiều yếu tố đan xen: mùa vụ, chiến dịch khuyến mãi, giá bán, xu hướng thị trường, thậm chí thời tiết và ngày lễ. Các mô hình học sâu có khả năng học những mối quan hệ phức tạp và dài hạn từ dữ liệu lịch sử, chẳng hạn cách doanh số thay đổi sau mỗi đợt khuyến mãi hay trước mỗi dịp lễ lớn, để đưa ra dự báo cho những tuần và tháng tiếp theo.
Với doanh nghiệp, một dự báo tốt hơn giúp lên kế hoạch tồn kho sát thực tế hơn, tránh tình trạng hết hàng vào đúng thời điểm nhu cầu cao hoặc tồn kho ứ đọng khi nhu cầu giảm. Bộ phận mua hàng chủ động hơn, bộ phận sản xuất và logistics sắp xếp nguồn lực hợp lý hơn, và ban lãnh đạo có cơ sở rõ ràng hơn khi đặt mục tiêu. Điều quan trọng là dự báo phải được dùng như một công cụ hỗ trợ quyết định, không phải như một con số tuyệt đối. Doanh nghiệp nên theo dõi độ lệch giữa dự báo và thực tế, hiểu rõ dự báo đáng tin trong khoảng thời gian nào và khi nào cần can thiệp bằng kinh nghiệm của con người — nhất là khi thị trường có biến động bất thường mà dữ liệu lịch sử chưa từng ghi nhận.
4.3. Gợi ý sản phẩm cho từng khách hàng
Khi khách hàng truy cập website thương mại điện tử hay ứng dụng mua sắm, hệ thống gợi ý đóng vai trò như một nhân viên bán hàng am hiểu từng người. Các mô hình học sâu phân tích lịch sử mua hàng, hành vi duyệt web, sản phẩm đã xem và cả hành vi của những khách hàng tương tự để đề xuất sản phẩm phù hợp. Điểm khác biệt so với gợi ý đơn giản theo danh mục là khả năng học những sở thích tinh tế: một khách hàng thích giày chạy bộ màu trung tính, chọn size nhất định và hay mua vào dịp cuối tuần sẽ nhận được gợi ý khác hẳn một khách hàng chỉ mua đồ thể thao cho trẻ em.
Gợi ý tốt giúp khách hàng tìm được món đồ cần mua nhanh hơn, giảm cảm giác choáng ngợp trước hàng nghìn sản phẩm và tăng khả năng họ quay lại. Với doanh nghiệp, đây là cách tận dụng dữ liệu sẵn có để tăng giá trị mỗi lượt truy cập mà không cần tăng chi phí quảng cáo. Dù vậy, gợi ý sản phẩm cũng cần được đặt trong giới hạn: gợi ý quá nhiều, quá dồn dập hay quá xâm phạm sẽ khiến khách hàng khó chịu. Doanh nghiệp nên kiểm thử nhiều cách hiển thị, tôn trọng quyền riêng tư và luôn để khách hàng dễ dàng bỏ qua gợi ý không phù hợp. Một hệ thống gợi ý có ích là hệ thống khiến khách hàng cảm thấy được thấu hiểu, chứ không phải bị theo dõi.
4.4. Kiểm soát chất lượng bằng thị giác máy
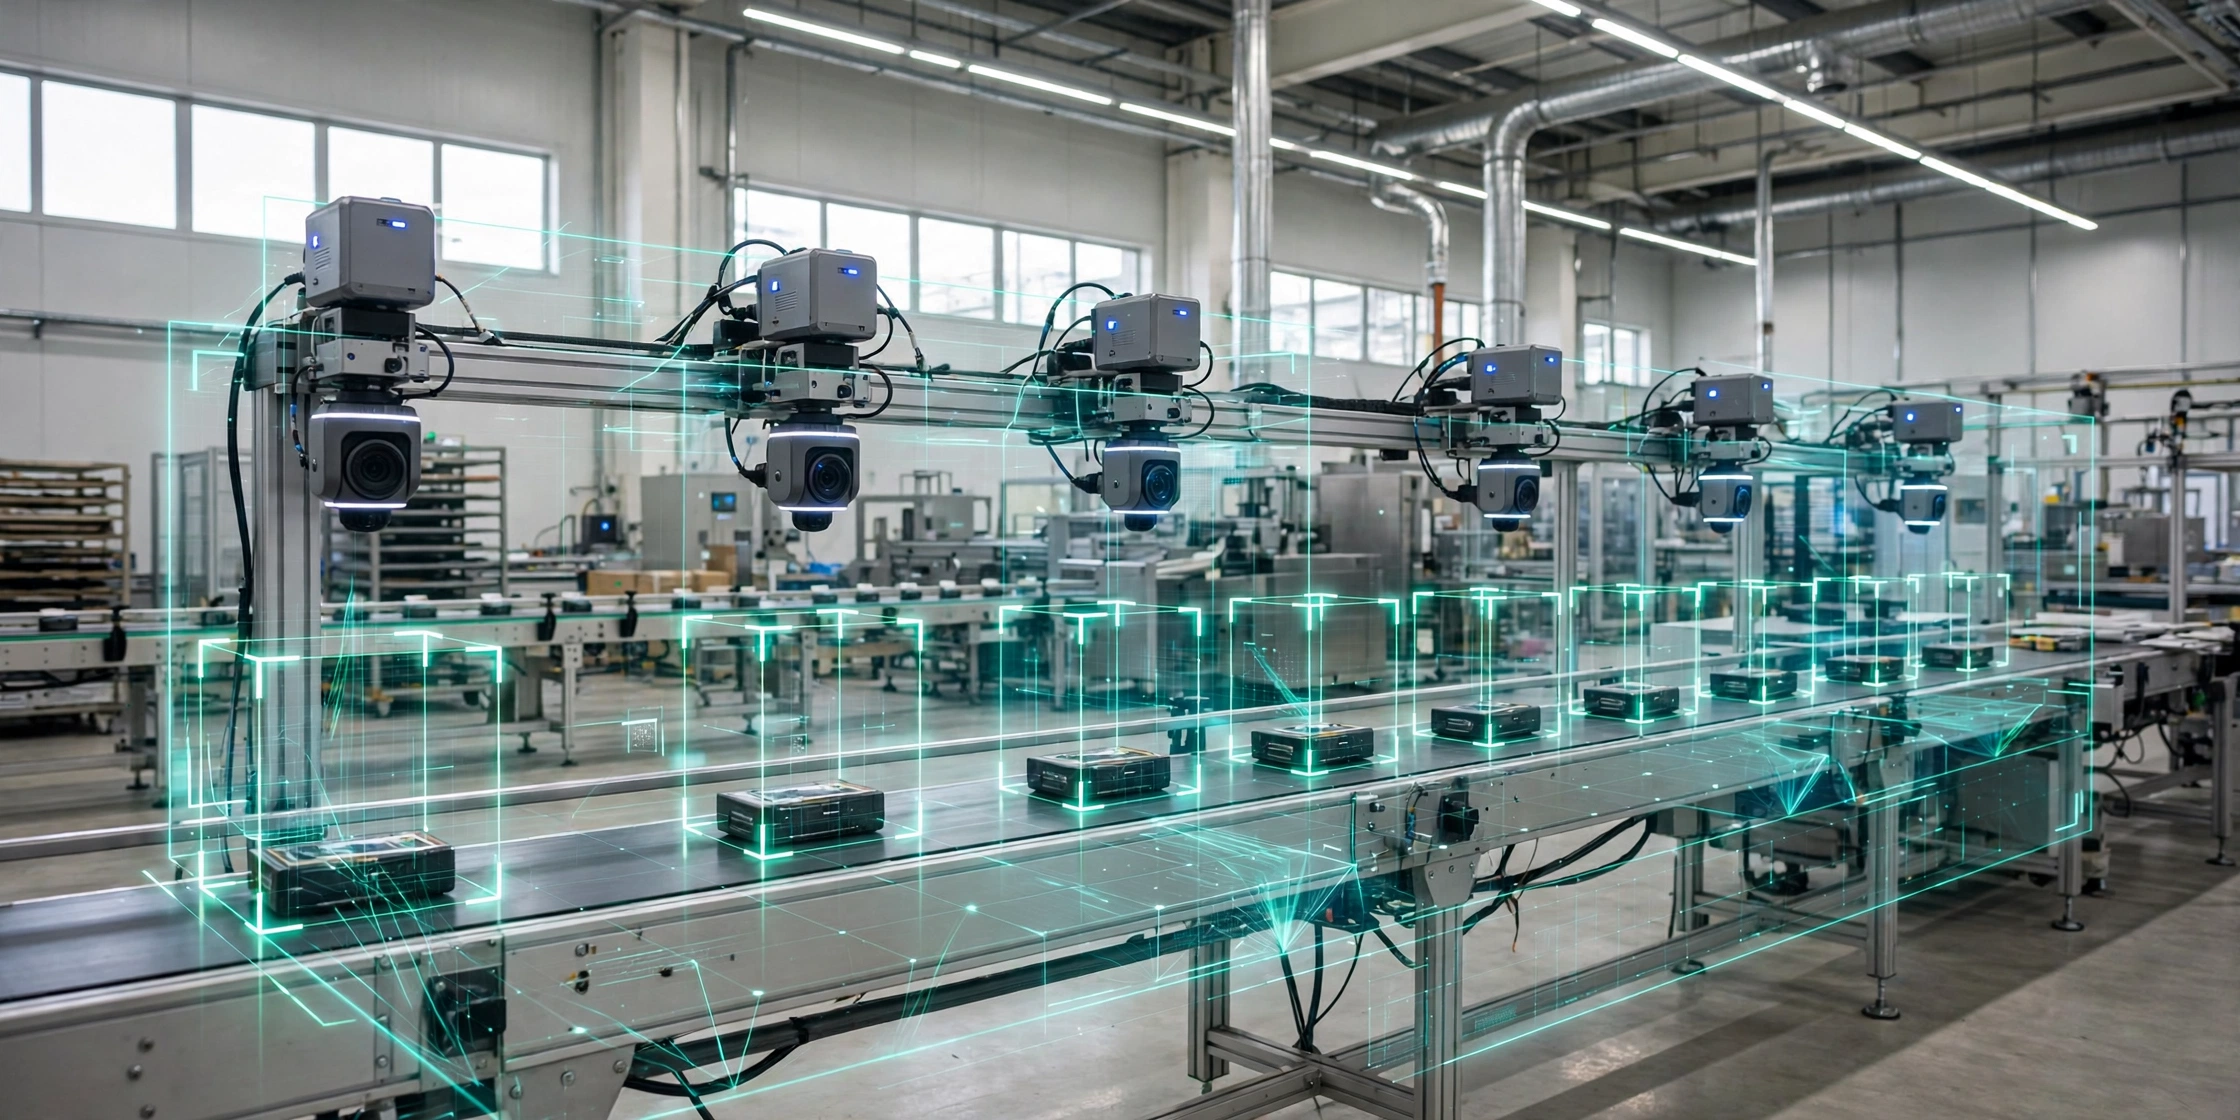
Trong sản xuất, thị giác máy là một trong những ứng dụng Deep Learning mang lại hiệu quả rõ ràng nhất. Camera trên dây chuyền chụp ảnh từng sản phẩm, mô hình học sâu phân tích hình ảnh để phát hiện vết xước, lỗi in, sai kích thước hay linh kiện lắp thiếu — những lỗi mà mắt người có thể bỏ sót sau nhiều giờ làm việc liên tục. Hệ thống có thể làm việc với tốc độ cao, ổn định cả ca ngày lẫn ca đêm, và ghi lại bằng chứng hình ảnh cho từng trường hợp nghi ngờ.
Khác với kiểm tra thủ công, thị giác máy còn giúp doanh nghiệp nhìn ra xu hướng: lỗi nào lặp lại nhiều nhất, xuất hiện ở công đoạn nào, vào thời điểm nào trong ca làm việc. Thông tin này giúp đội ngũ kỹ thuật xử lý tận gốc thay vì chỉ loại bỏ sản phẩm lỗi. Tất nhiên, triển khai thị giác máy không chỉ là lắp camera và chạy mô hình. Doanh nghiệp cần thu thập đủ ảnh mẫu của cả sản phẩm đạt chuẩn lẫn sản phẩm lỗi, chuẩn hoá điều kiện ánh sáng và góc chụp, đồng thời tính đến việc mô hình cần được cập nhật khi sản phẩm hay quy trình thay đổi. Bắt đầu từ một công đoạn, một loại lỗi cụ thể thường là cách làm khôn ngoan hơn việc tự động hoá toàn bộ dây chuyền ngay từ đầu.
4.5. Tài chính và phát hiện gian lận
Trong tài chính, Deep Learning được dùng để nhận diện những giao dịch bất thường giữa hàng triệu giao dịch bình thường. Mô hình học thói quen giao dịch của từng khách hàng — họ thường chi tiêu ở đâu, vào thời gian nào, với số tiền ra sao — và cảnh báo khi xuất hiện giao dịch lệch khỏi thói quen đó. Trong thẩm định tín dụng, mô hình có thể phân tích nhiều nguồn dữ liệu để hỗ trợ đánh giá mức độ rủi ro, giúp quy trình nhanh hơn và nhất quán hơn so với việc chỉ dựa vào một vài tiêu chí thủ công. Ứng dụng này đòi hỏi sự thận trọng đặc biệt, vì quyết định liên quan đến tiền bạc ảnh hưởng trực tiếp đến khách hàng: một cảnh báo gian lận sai có thể khiến khách hàng bị khóa thẻ oan, còn một quyết định tín dụng thiếu minh bạch có thể gây khiếu nại và rủi ro pháp lý. Vì vậy, doanh nghiệp tài chính thường kết hợp mô hình với quy trình xét duyệt của con người, đồng thời tuân thủ các quy định về bảo vệ dữ liệu và quản trị rủi ro của ngành.
4.6. Nhân sự và tuyển dụng
Trong nhân sự, Deep Learning hỗ trợ ở những khâu tốn nhiều thời gian nhưng có tính lặp lại cao, chẳng hạn sàng lọc hồ sơ. Mô hình có thể đọc và phân loại hàng trăm hồ sơ ứng tuyển theo yêu cầu của vị trí, giúp đội ngũ tuyển dụng tập trung vào những ứng viên phù hợp nhất. Các công cụ phân tích ngôn ngữ còn hỗ trợ tóm tắt nội dung phỏng vấn, theo dõi mức độ hài lòng của nhân viên qua khảo sát nội bộ và phát hiện sớm dấu hiệu nhân viên có nguy cơ rời bỏ để doanh nghiệp kịp thời quan tâm. Đây cũng là lĩnh vực cần cân nhắc kỹ về đạo đức và tính công bằng: nếu dữ liệu huấn luyện chứa thiên kiến, mô hình có thể học theo và lặp lại thiên kiến đó một cách âm thầm. Vì vậy, doanh nghiệp nên dùng AI trong tuyển dụng như một công cụ hỗ trợ sàng lọc sơ bộ, không để máy tự quyết định loại bỏ ứng viên, và luôn có người kiểm tra lại.
4.7. Marketing và phân tích hành vi khách hàng
Trong marketing, Deep Learning giúp doanh nghiệp hiểu khách hàng theo nhóm và theo từng cá nhân. Mô hình phân tích dữ liệu tương tác — khách hàng mở email nào, bấm vào quảng cáo nào, ở lại trang nào lâu nhất — để phân loại khách hàng thành các nhóm có hành vi tương đồng, từ đó thiết kế thông điệp và ưu đãi phù hợp với từng nhóm. Một ứng dụng khác là phân tích cảm xúc từ phản hồi của khách hàng: mô hình đọc hàng nghìn bình luận, đánh giá và tin nhắn để nhận biết khách hàng đang hài lòng, thất vọng hay chỉ đang thắc mắc, giúp đội ngũ marketing và chăm sóc khách hàng phản ứng nhanh hơn. Tuy nhiên, marketing dựa trên dữ liệu phải đi kèm với tôn trọng quyền riêng tư: thu thập dữ liệu minh bạch, cho khách hàng quyền lựa chọn và không vượt qua ranh giới giữa “hiểu khách hàng” và “theo dõi khách hàng”.
5. Lợi ích thực tế và giới hạn, thách thức
Nhìn tổng thể, Deep Learning mang lại cho doanh nghiệp ba nhóm lợi ích chính. Thứ nhất là hiệu quả: nhiều tác vụ lặp lại — từ trả lời câu hỏi thường gặp, phân loại tài liệu đến kiểm tra sản phẩm — được tự động hoá, giúp nhân viên tập trung vào công việc cần tư duy và giao tiếp với con người. Thứ hai là chất lượng quyết định: khi dữ liệu đủ tốt, mô hình có thể phát hiện mẫu mà con người khó thấy, giúp dự báo sát hơn và giảm sai sót do mệt mỏi hay cảm tính. Thứ ba là quy mô: một hệ thống tốt có thể phục vụ hàng nghìn khách hàng cùng lúc hay kiểm tra hàng nghìn sản phẩm mỗi ca mà không cần tăng nhân sự theo cùng tỷ lệ.
Bên cạnh lợi ích, doanh nghiệp cần nhìn thẳng vào những giới hạn. Hạn chế lớn nhất là sự phụ thuộc vào dữ liệu: mô hình chỉ tốt như dữ liệu dùng để huấn luyện nó, và việc thu thập, làm sạch, gắn nhãn dữ liệu thường tốn nhiều công sức hơn cả việc xây dựng mô hình. Tiếp theo là chi phí — hạ tầng, duy trì, cập nhật mô hình và tích hợp vào quy trình hiện có — cùng thách thức nhân lực: doanh nghiệp cần người vừa hiểu kỹ thuật vừa hiểu nghiệp vụ để đặt đúng bài toán và đánh giá kết quả. Cuối cùng là tính khó giải thích của mô hình và nguy cơ thiên kiến từ dữ liệu quá khứ, cùng yêu cầu bảo vệ dữ liệu cá nhân của khách hàng và nhân viên. Một dự án Deep Learning thành công vì vậy không chỉ được đo bằng độ chính xác của mô hình, mà còn bằng cách doanh nghiệp quản trị rủi ro và giữ được lòng tin của khách hàng.
6. Doanh nghiệp Việt Nam bắt đầu từ đâu? Lộ trình 5 bước thực tế
Một sai lầm phổ biến là bắt đầu bằng công nghệ rồi mới tìm bài toán. Lộ trình thực tế hơn là đi ngược lại: bắt đầu từ vấn đề kinh doanh, thử nghiệm nhỏ, đo lường rõ ràng rồi mới mở rộng.
- Bước 1: Chọn một bài toán cụ thể, có giá trị rõ ràng. Hãy chọn bài toán mà mọi người đều cảm nhận được nỗi đau: đội chăm sóc khách hàng quá tải vì câu hỏi lặp lại, kho hàng thường xuyên thiếu hoặc thừa, hay đội kiểm tra chất lượng không theo kịp tốc độ dây chuyền. Bài toán tốt là bài toán đo lường được — thời gian xử lý, tỷ lệ lỗi, chi phí tồn kho — để sau này biết dự án có hiệu quả hay không.
- Bước 2: Đánh giá dữ liệu hiện có. Dữ liệu đang nằm ở đâu, có đủ nhiều không, có sạch không, có được gắn nhãn đúng không? Nếu dữ liệu khách hàng nằm rải rác ở nhiều file hay ảnh sản phẩm lỗi chưa từng được lưu lại có hệ thống, hãy đầu tư vào việc tổ chức và làm sạch dữ liệu trước, thay vì vội vàng huấn luyện mô hình.
- Bước 3: Làm thử nghiệm nhỏ (PoC) trong thời gian ngắn. Xây dựng một bản thử nghiệm với phạm vi hẹp — một chatbot trả lời một nhóm câu hỏi nhất định, một mô hình dự báo cho một nhóm sản phẩm, hay một hệ thống kiểm tra lỗi tại một công đoạn. Mục tiêu là trả lời câu hỏi: công nghệ này có giải quyết được bài toán của chúng ta không, và với mức chi phí nào?
- Bước 4: Tích hợp vào quy trình và đào tạo đội ngũ. Xác định rõ ai sử dụng kết quả của hệ thống, khi nào họ can thiệp và quy trình xử lý ngoại lệ ra sao; đồng thời đào tạo nhân viên hiểu hệ thống làm được gì, không làm được gì và cách phối hợp với nó. Sự thay đổi về quy trình và thói quen làm việc thường khó hơn cả phần kỹ thuật.
- Bước 5: Đo lường, duy trì và mở rộng có kiểm soát. Theo dõi liên tục: mô hình còn chính xác không, người dùng có hài lòng không, chi phí có như kỳ vọng không? Khi bài toán đầu tiên đã chứng minh được giá trị, mới mở rộng sang bài toán tiếp theo, dựa trên kinh nghiệm và dữ liệu đã tích lũy được.
7. Câu hỏi thường gặp về Deep Learning
Deep Learning có thay thế con người không? Trong hầu hết trường hợp, Deep Learning thay thế các tác vụ lặp lại, không thay thế vai trò ra quyết định và giao tiếp của con người. Chatbot xử lý câu hỏi thường gặp, nhưng nhân viên vẫn cần thiết cho những trường hợp phức tạp và nhạy cảm. Thị giác máy phát hiện lỗi nhanh, nhưng kỹ sư vẫn là người quyết định cách khắc phục tận gốc. Cách nhìn thực tế là con người và hệ thống bổ sung cho nhau, chứ không phải một bên thay thế hoàn toàn bên còn lại.
Doanh nghiệp nhỏ có ứng dụng được Deep Learning không? Có, nếu chọn đúng bài toán và đúng cách tiếp cận. Doanh nghiệp nhỏ không cần tự xây dựng mô hình từ đầu; có thể bắt đầu từ các dịch vụ và giải pháp có sẵn, hoặc hợp tác với đơn vị chuyên môn để làm thử nghiệm nhỏ. Điều quan trọng là bài toán phải đủ rõ ràng, dữ liệu đủ tốt và chi phí phải tương xứng với giá trị mang lại.
Deep Learning cần bao nhiêu dữ liệu? Không có con số chung cho mọi bài toán. Nhìn chung, Deep Learning cần nhiều dữ liệu hơn Machine Learning truyền thống, đặc biệt với hình ảnh, âm thanh và văn bản. Tuy nhiên, doanh nghiệp không phải lúc nào cũng bắt đầu từ con số không: có thể tận dụng các mô hình đã được huấn luyện sẵn rồi tinh chỉnh cho phù hợp với dữ liệu của mình, hoặc bắt đầu với bài toán mà dữ liệu sẵn có đã tương đối đầy đủ.
Triển khai Deep Learning mất bao lâu? Thời gian phụ thuộc vào mức độ sẵn sàng của dữ liệu, độ phức tạp của bài toán và phạm vi triển khai. Một thử nghiệm nhỏ có thể hoàn thành trong vài tuần, trong khi một hệ thống tích hợp sâu vào quy trình kinh doanh có thể cần nhiều tháng, bao gồm thời gian thu thập và làm sạch dữ liệu, huấn luyện mô hình, tích hợp hệ thống và đào tạo đội ngũ. Doanh nghiệp nên yêu cầu lộ trình rõ ràng với các mốc kiểm tra cụ thể, thay vì một lời hứa chung chung về thời gian.
8. Kết bài
Deep Learning không phải là phép màu, cũng không phải là xu hướng nhất thời. Đó là một công cụ mạnh mẽ để doanh nghiệp học từ dữ liệu của chính mình, tự động hoá những việc lặp lại và ra quyết định sát thực tế hơn — với điều kiện bài toán được chọn đúng, dữ liệu được chuẩn bị tốt và con người vẫn giữ vai trò kiểm soát cuối cùng. Doanh nghiệp Việt Nam không cần phải chạy theo mọi công nghệ mới, nhưng cũng không nên đứng ngoài khi công nghệ đã đủ trưởng thành để giải quyết những bài toán cụ thể trong chăm sóc khách hàng, dự báo, gợi ý sản phẩm hay kiểm soát chất lượng.
Điểm khởi đầu tốt nhất không phải là một dự án lớn, mà là một cuộc trao đổi thẳng thắn về bài toán của doanh nghiệp: đâu là điểm đau lớn nhất, dữ liệu hiện có ra sao, và một thử nghiệm nhỏ sẽ trông như thế nào. Từ đó, doanh nghiệp có thể từng bước xây dựng năng lực AI cho riêng mình, thay vì đầu tư dàn trải rồi bỏ dở giữa chừng.
Nếu doanh nghiệp của bạn đang cân nhắc ứng dụng Deep Learning nhưng chưa biết bắt đầu từ đâu, đội ngũ ADC/AIA sẵn sàng cùng bạn phân tích bài toán, đánh giá dữ liệu và đề xuất lộ trình thử nghiệm phù hợp. Hãy liên hệ ngay hôm nay để được tư vấn: gọi 0939 936 168 hoặc gửi yêu cầu qua trang liên hệ của ADC/AIA. Một cuộc trao đổi đúng lúc có thể giúp doanh nghiệp của bạn tiết kiệm được nhiều tháng loay hoay và đi đúng hướng ngay từ bước đầu tiên.
